

Pendant des décennies, une page Web a principalement été conçue pour deux acteurs : l’internaute qui la consulte et le moteur de recherche qui tente de la comprendre.
L’arrivée des agents IA commence à faire apparaître un troisième type de lecteur.
Un logiciel capable de visiter un site, d’en extraire une information, de la comparer à d’autres sources ou de l’intégrer dans un processus automatisé.
Et WordPress vient de faire un petit pas technique qui illustre particulièrement bien cette évolution.
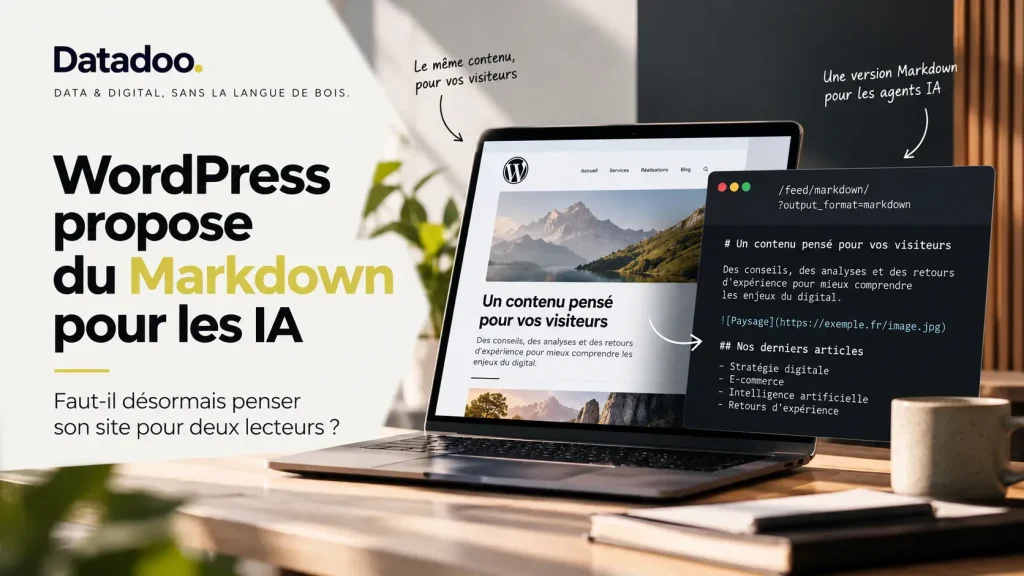
Avec la version 1.4.0 de son plugin canonique AI, publiée le 5 octobre 2026, WordPress expérimente les Markdown Feeds : une représentation supplémentaire des contenus du site, débarrassée d’une partie de la complexité du HTML et destinée notamment aux agents IA, modèles de langage et outils automatisés. (WordPress.org)
Attention cependant à ce que cette nouveauté ne dit pas.
WordPress n’annonce pas une nouvelle technique permettant de « mieux ressortir dans ChatGPT ». Rien ne démontre aujourd’hui qu’un contenu disponible en Markdown sera davantage cité par ChatGPT, Google AI Overviews, Perplexity ou un autre moteur génératif.
Le sujet est probablement plus intéressant que cela.
Nous commençons à voir apparaître différentes représentations d’un même contenu selon celui qui doit le consommer : l’humain ou la machine.
Et cela pourrait progressivement modifier la façon dont nous concevons l’architecture de l’information sur le Web.
Sommaire
- Que sont les Markdown Feeds de WordPress AI ?
- Comment fonctionne concrètement la version Markdown ?
- Que reste-t-il lorsqu’on retire le HTML ?
- Pourquoi le Markdown intéresse-t-il les agents IA ?
- Le Markdown peut-il améliorer la visibilité dans ChatGPT ?
- HTML, Schema.org et Markdown : trois rôles différents
- Vers un Web conçu pour deux lecteurs ?
- Quel rapport avec les agents IA ?
- Pourquoi les embeddings de WordPress AI 1.4 sont également importants
- GEO : rendre l’information compréhensible et accessible
- Mini-audit : votre contenu est-il réellement exploitable par une machine ?
- Faut-il activer WordPress AI pour obtenir les Markdown Feeds ?
- Que retenir ?
Que sont les Markdown Feeds de WordPress AI ?
Commençons par une précision essentielle : les Markdown Feeds ne font pas partie, à ce jour, du cœur de WordPress.
Ils sont introduits dans AI 1.4.0, le plugin canonique développé par le projet WordPress pour expérimenter et faire évoluer ses fonctionnalités liées à l’intelligence artificielle.
Et WordPress les qualifie explicitement d’Experiment. (Make WordPress)
Il ne s’agit donc pas d’affirmer que « WordPress sert désormais toutes les pages en Markdown ».
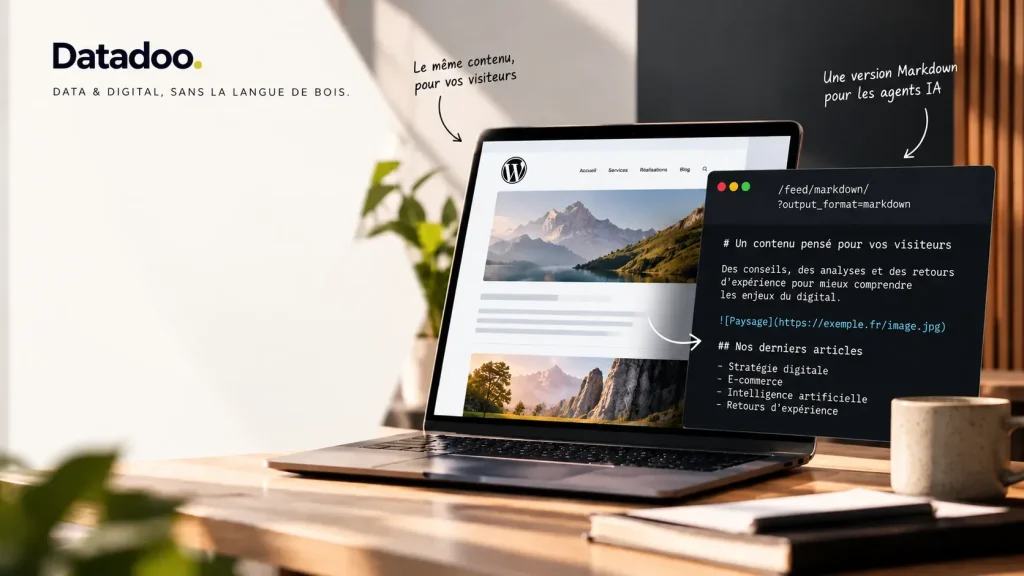
Lorsque l’expérience est activée dans le plugin AI, WordPress peut proposer une représentation Markdown du contenu en parallèle de sa représentation HTML traditionnelle.
L’objectif formulé par WordPress est clair : fournir une version plus propre et structurée du contenu aux agents IA, modèles de langage, outils de développement et autres systèmes capables de travailler efficacement avec du Markdown. (Make WordPress)
Ce n’est d’ailleurs pas une idée sortie de nulle part.
Depuis mars 2026, une grande partie de WordPress.org lui-même peut déjà fournir ses contenus en Markdown. L’équipe WordPress expliquait alors vouloir faciliter l’exploitation de sa documentation par les agents IA et les grands modèles de langage, afin notamment qu’ils puissent s’appuyer plus facilement sur une source officielle et à jour. (Make WordPress)
AI 1.4.0 transpose désormais cette logique dans le plugin canonique WordPress AI.
Comment fonctionne concrètement la version Markdown ?
Deux mécanismes sont officiellement documentés dans AI 1.4.0.
Un flux Markdown
Lorsque l’expérience est activée, WordPress crée un flux accessible à l’adresse :
/feed/markdown/
WordPress précise que ce format est disponible dans les différents contextes où ses feeds peuvent être utilisés. (Make WordPress)
Il s’agit donc d’une logique comparable, dans son principe, aux flux déjà proposés par WordPress, mais avec une représentation du contenu en Markdown.
Une version Markdown d’un article ou d’une page
Une publication individuelle peut également être demandée en ajoutant le paramètre :
?output_format=markdown
à son URL.
Une page disponible normalement à :
https://exemple.fr/mon-article
peut ainsi disposer, lorsque l’expérience est active, d’une représentation demandée via :
https://exemple.fr/mon-article/?output_format=markdown
Le navigateur et l’internaute continuent donc à utiliser normalement la page HTML.
Un logiciel peut, lui, demander une représentation plus sobre du même contenu.
Une nuance technique mérite d’être signalée : WordPress.org et le plugin WordPress AI n’utilisent pas exactement les mêmes paramètres documentés.
L’infrastructure de WordPress.org annoncée en mars accepte notamment ?output_format=md ainsi que l’en-tête HTTP Accept: text/markdown. Pour AI 1.4.0, l’annonce officielle documente /feed/markdown/ et ?output_format=markdown. (Make WordPress)
Il vaut donc mieux se référer à l’implémentation réellement utilisée plutôt que de considérer ces syntaxes comme interchangeables.
Que reste-t-il lorsqu’on retire le HTML ?
Le but n’est évidemment pas de transformer une page riche en un simple bloc de texte brut.
La conversion mise en place par WordPress préserve notamment les structures courantes comme :
- les titres ;
- les liens ;
- les images ;
- les listes ;
- les citations ;
- le code.
Les titres d’articles, extraits et autres éléments des feeds sont également normalisés afin d’éviter que des entités HTML viennent polluer la représentation Markdown. (Make WordPress)
En revanche, une bonne partie de ce qui appartient à la présentation HTML n’a plus besoin d’être transportée de la même manière.
C’est précisément là que réside l’intérêt.
Une page Web moderne ne contient pas uniquement l’information que l’internaute est venu chercher.
Elle contient également la structure du thème, des classes CSS, des conteneurs, des composants d’interface, des éléments de navigation et potentiellement une quantité importante de code nécessaire à son affichage ou à son fonctionnement.
Pour un navigateur, cette complexité est normale.
Pour un système qui veut principalement comprendre :
« De quoi parle cette page et quelles informations contient-elle ? »
elle peut être superflue.
Le Markdown fournit alors une représentation intermédiaire intéressante : beaucoup plus légère que le document Web complet, tout en conservant suffisamment de structure pour distinguer un titre, un paragraphe, une liste ou un lien.
Pourquoi le Markdown est-il intéressant pour un agent ou un LLM ?
Un modèle de langage est parfaitement capable de traiter du HTML.
Il serait donc faux d’opposer un HTML « illisible par l’IA » à un Markdown « lisible par l’IA ».
Le problème est ailleurs.
Lorsqu’un système cherche avant tout à exploiter l’information contenue dans une page, une représentation plus sobre peut réduire le travail nécessaire pour extraire le contenu pertinent de son enveloppe technique et visuelle.
Prenons une information très simple :
## Conditions de livraison
En Markdown, sa fonction est immédiatement identifiable : il s’agit d’un titre de deuxième niveau.
Dans une page Web réelle, le même contenu peut être entouré de multiples conteneurs et attributs nécessaires au design, au responsive, aux interactions ou au page builder.
Un navigateur a besoin d’une partie de cette information.
Un agent qui cherche simplement les conditions de livraison, beaucoup moins.
C’est également pourquoi WordPress.org explique avoir choisi le Markdown pour faciliter la consommation de sa documentation par les agents et modèles de langage. (Make WordPress)
Le gain potentiel concerne donc avant tout l’ingestion et l’exploitation du contenu, pas une capacité magique du Markdown à faire comprendre une mauvaise information.
Une information imprécise restera imprécise, qu’elle soit écrite en HTML ou en Markdown.
Le Markdown peut-il améliorer la visibilité dans ChatGPT ?
C’est probablement la question qui va rapidement apparaître :
« Si je propose mes contenus en Markdown, ChatGPT va-t-il davantage citer mon site ? »
Aujourd’hui, la réponse sérieuse est : nous n’en savons rien, et aucune preuve ne permet de l’affirmer.
WordPress indique que cette représentation rend le contenu plus facilement accessible aux systèmes IA et autres consommateurs de Markdown. Il ne prétend pas qu’elle constitue un facteur de classement, de citation ou de visibilité dans les moteurs génératifs. (Make WordPress)
Il faut distinguer deux notions.
Faciliter techniquement la consommation d’une information n’est pas la même chose que convaincre un système de sélectionner cette information dans sa réponse.
Un moteur génératif peut tenir compte d’une multitude de paramètres : disponibilité de la source, qualité et précision de l’information, fraîcheur, autorité, concordance avec d’autres sources, contexte de la requête, architecture propre au système ou encore mécanismes de recherche et de retrieval utilisés.
Les critères précis diffèrent par ailleurs selon les plateformes et évoluent rapidement.
Dire aujourd’hui :
« Ajoutez une version Markdown et vous améliorerez votre GEO »
serait donc aller beaucoup plus loin que ce que les faits permettent d’affirmer.
En revanche, cette expérimentation constitue un signal intéressant.
Les CMS commencent à réfléchir explicitement à la façon dont leur contenu peut être consommé par des systèmes non humains.
Et c’est là que le sujet rejoint réellement le GEO.
HTML, Schema.org et Markdown : trois rôles différents
On pourrait se demander pourquoi créer une représentation Markdown alors que le Web dispose déjà du HTML sémantique et des données structurées.
Parce que ces technologies ne répondent pas exactement au même besoin.
HTML : structurer le document Web
Le HTML décrit la structure de la page et permet au navigateur d’en construire la représentation.
Un bon HTML sémantique indique notamment quels éléments sont des titres, paragraphes, listes, liens, tableaux ou sections.
Il reste la base du Web.
Schema.org : expliciter la signification de certaines données
Les données structurées ajoutent une couche différente.
Elles peuvent indiquer explicitement qu’une information représente une organisation, un produit, un prix, un auteur, un événement, une recette ou une autre entité.
Google explique par exemple utiliser les données structurées comme des indices explicites permettant de comprendre le sens du contenu d’une page. (Google for Developers)
Schema.org définit pour cela un vocabulaire partagé décrivant des entités, leurs propriétés et leurs relations. (Schema.org)
Markdown : proposer une représentation simplifiée du contenu
Le Markdown ne remplace pas Schema.org.
Il ne dit pas nécessairement :
« 49,90 € est le prix de ce produit et cette autre valeur représente son stock. »
Il fournit plutôt une représentation textuelle structurée, plus simple à ingérer.
On pourrait donc résumer grossièrement les rôles ainsi :
HTML : voici le document.
Schema.org : voici ce que signifient explicitement certaines données.
Markdown : voici une représentation plus sobre de son contenu.
Ces trois couches peuvent parfaitement coexister.
Vers un Web conçu pour deux lecteurs ?
C’est probablement la question la plus intéressante derrière cette annonce.
Pendant longtemps, nous avons conçu des sites principalement pour l’expérience humaine, puis aidé les moteurs de recherche à comprendre cette expérience.
L’arrivée des agents pourrait progressivement créer une autre logique :
une même source d’information, mais plusieurs représentations adaptées au consommateur.
Pour l’humain :
- identité visuelle ;
- navigation ;
- animations ;
- composants interactifs ;
- mise en page ;
- images ;
- formulaires ;
- expérience de marque.
Pour la machine :
- contenu principal identifiable ;
- structure claire ;
- données explicites ;
- relations entre les informations ;
- format facilement ingérable ;
- accès technique prévisible.
Cela ne signifie pas que nous allons créer « un site pour Google et un site pour les IA ».
Ce serait même une mauvaise lecture du phénomène.
L’enjeu consiste plutôt à maintenir une même information de référence capable d’être représentée de différentes manières sans se contredire.
Une page produit pourrait par exemple disposer simultanément :
- de son expérience HTML pour le visiteur ;
- de données Schema.org décrivant explicitement le produit ;
- d’une représentation Markdown plus simple à exploiter par un agent ;
- et d’une API utilisée par d’autres systèmes.
Le contenu reste le même.
Ce sont ses interfaces de consommation qui se multiplient.
Quel rapport avec la montée des agents IA ?
Cette évolution prend davantage de sens lorsqu’on ne pense plus uniquement aux chatbots.
Les systèmes IA commencent progressivement à pouvoir agir sur le Web.
Un agent peut avoir besoin de rechercher une documentation, comparer des offres, consulter plusieurs pages, identifier une caractéristique produit ou récupérer une information avant d’effectuer une autre action.
Dans ce contexte, le site Web n’est plus seulement une destination.
Il devient également une source de données interrogée par des logiciels.
WordPress travaille d’ailleurs parallèlement sur des briques permettant aux systèmes IA d’interagir avec WordPress, notamment autour de son Abilities API et des usages liés au MCP.
Les Markdown Feeds doivent donc être replacés dans un mouvement plus large : rendre WordPress non seulement utilisable avec de l’IA, mais progressivement plus facilement exploitable par des systèmes agentiques.
La question pour les entreprises pourrait alors évoluer.
Hier :
« Mon site est-il correctement affiché sur mobile ? »
Puis :
« Google comprend-il correctement mes pages ? »
Et demain, de plus en plus :
« Un agent est-il capable d’identifier et d’exploiter correctement l’information publiée sur mon site ? »
Pourquoi les embeddings de WordPress AI 1.4 sont également importants
Les Markdown Feeds sont la nouveauté la plus visible pour le sujet qui nous intéresse.
Mais AI 1.4.0 introduit parallèlement une évolution technique peut-être encore plus structurante.
WordPress renforce son infrastructure d’embeddings.
Un embedding consiste, très schématiquement, à représenter le sens d’un contenu sous forme de vecteur numérique.
Cela permet ensuite de comparer la proximité sémantique de plusieurs contenus.
Deux textes peuvent employer des mots différents tout en traitant d’un sujet très proche : leurs représentations vectorielles permettent précisément de mesurer ce type de proximité.
AI 1.4.0 ajoute notamment une couche de stockage et de gestion des vecteurs avec une nouvelle table :
wpai_embeddings
WordPress peut y conserver le vecteur ainsi que des informations sur le fournisseur et le modèle ayant servi à le générer. (Make WordPress)
Deux nouvelles classes, Vector_Math et Vector_Ranker, permettent également d’effectuer des calculs de similarité et de classer des résultats.
WordPress précise cependant qu’il s’agit actuellement surtout d’une infrastructure destinée aux développeurs, et non d’une nouvelle fonctionnalité prête à l’emploi pour l’utilisateur final.
Elle pose les fondations de futurs usages comme :
- la recherche sémantique ;
- le retrieval ;
- les recommandations ;
- la recherche de contenus proches ;
- ou des fonctionnalités IA ayant besoin de comprendre les relations sémantiques entre les contenus. (Make WordPress)
Là encore, il ne faut pas transformer cela en promesse SEO.
Le rapprochement est surtout architectural.
D’un côté, WordPress expérimente une représentation du contenu plus facilement consommable par des machines.
De l’autre, il développe une infrastructure permettant de représenter et rechercher ce contenu selon son sens, et plus uniquement selon des mots-clés ou des identifiants.
Ce sont deux briques différentes d’un Web de plus en plus exploité par des systèmes IA.
GEO : rendre l’information compréhensible et accessible
Cette évolution permet aussi de remettre un peu d’ordre dans le discours autour du GEO, ou Generative Engine Optimization.
Le GEO est parfois présenté comme une nouvelle liste d’astuces permettant de « hacker ChatGPT ».
C’est probablement la mauvaise façon d’aborder le sujet.
Pour qu’un système puisse utiliser correctement une information publiée par une entreprise, trois conditions deviennent progressivement essentielles.
1. Produire une information fiable et suffisamment claire
Aucune optimisation technique ne compensera durablement une information pauvre, ambiguë ou contradictoire.
Une entreprise doit pouvoir expliquer clairement :
- qui elle est ;
- ce qu’elle propose ;
- à qui ;
- dans quelles conditions ;
- avec quelles caractéristiques ;
- et avec quelles preuves.
La qualité de l’information reste le premier niveau.
2. Structurer cette information pour qu’elle puisse être comprise
Une information peut être exacte tout en étant difficile à interpréter.
Une hiérarchie éditoriale cohérente, un HTML propre, des titres explicites et des données structurées pertinentes contribuent à réduire cette ambiguïté.
Schema.org joue ici un rôle particulièrement intéressant puisqu’il permet de qualifier explicitement certaines entités et relations.
3. Rendre cette information techniquement accessible
Enfin, une excellente information parfaitement structurée ne sert pas à un système qui ne peut pas y accéder.
Cela pose des questions de crawl, de rendu JavaScript, de robots.txt, de protections anti-bot, d’authentification et désormais potentiellement de formats de représentation.
Les Markdown Feeds interviennent surtout à ce troisième niveau.
Ils offrent une possibilité supplémentaire pour exposer proprement le contenu.
Cela n’en fait pas un facteur GEO démontré.
Mais cela illustre très bien une tendance : la qualité d’un site pourrait de plus en plus se mesurer également à sa capacité à exposer proprement son information aux machines autorisées à la consulter.
Mini-audit : votre contenu est-il réellement exploitable par une machine ?
Il n’est pas nécessaire d’attendre que les Markdown Feeds deviennent une fonctionnalité mature pour commencer à se poser la bonne question.
Prenez quelques pages importantes de votre site et vérifiez les points suivants.
Les titres et la hiérarchie Hn sont-ils cohérents ?
Un H1 clair et une hiérarchie logique de H2/H3 permettent de comprendre rapidement l’organisation du document.
Si la structure n’est compréhensible que grâce à la taille, la couleur ou la position visuelle des textes, elle perd une partie de son sens une fois la présentation supprimée.
Les informations importantes existent-elles réellement sous forme de texte ?
Une information essentielle ne devrait pas uniquement être enfermée dans :
- une image ;
- une infographie ;
- une animation ;
- une vidéo sans transcription ;
- ou un composant impossible à interpréter sans interaction.
Demandez-vous ce qu’il reste de votre page lorsque l’on retire son design.
Le contenu dépend-il excessivement de JavaScript ?
JavaScript n’est pas intrinsèquement problématique.
Mais si une information essentielle n’existe qu’après l’exécution d’un scénario complexe côté navigateur, son exploitation devient mécaniquement plus dépendante des capacités du système qui visite le site.
Vos données structurées sont-elles cohérentes ?
Vérifiez que les données Schema.org correspondent réellement au contenu visible et utilisent les bons types.
Google recommande d’ailleurs que les données structurées représentent fidèlement les informations visibles par l’utilisateur. (Google for Developers)
Les informations concernant votre entreprise et vos produits sont-elles homogènes ?
Nom, description, caractéristiques, tarifs, disponibilité, coordonnées ou zones d’intervention ne devraient pas se contredire entre plusieurs pages.
Pour un système qui tente de consolider une information, les incohérences créent de l’incertitude.
Le contenu principal est-il identifiable ?
Une machine doit pouvoir distinguer l’information recherchée de la navigation, des recommandations, du footer ou des composants annexes.
Vos URLs sont-elles stables ?
Une architecture d’URL stable facilite la référence durable à une ressource.
Multiplier les changements d’URL sans redirections correctes fragmente inutilement l’accès à l’information.
Votre politique vis-à-vis des crawlers et agents est-elle claire ?
Vérifiez notamment vos règles robots.txt, vos protections de sécurité, CDN et systèmes anti-bot.
Il est inutile de vouloir rendre une information accessible à certains systèmes si l’infrastructure les bloque systématiquement — et inversement, toutes les organisations ne souhaitent pas nécessairement ouvrir leurs contenus à tous les agents.
Cette décision doit être consciente.
Si vous exposez du Markdown, l’avez-vous réellement contrôlé ?
Une conversion automatique ne garantit pas une représentation parfaite.
WordPress.org reconnaît lui-même que tous les contenus ne se convertissent pas aussi bien en Markdown. (Make WordPress)
Il faut donc vérifier le résultat sur plusieurs types de pages.
Les différentes représentations racontent-elles la même chose ?
C’est probablement le contrôle le plus important.
HTML, données structurées, API et éventuelle représentation Markdown ne devraient pas présenter des informations contradictoires.
La représentation machine ne doit pas devenir une seconde version éditoriale du site.
Elle doit représenter correctement la même source d’information.
Faut-il installer WordPress AI uniquement pour obtenir les Markdown Feeds ?
À ce stade : probablement pas.
WordPress qualifie encore explicitement Markdown Feeds d’expérience.
AI 1.4.0 est un plugin canonique destiné notamment à expérimenter des fonctionnalités susceptibles d’évoluer. Les Markdown Feeds ne sont pas une fonctionnalité du cœur de WordPress. (Make WordPress)
Installer un plugin de cette nature en production uniquement dans l’espoir hypothétique d’améliorer sa visibilité dans les moteurs génératifs serait donc difficile à justifier aujourd’hui.
D’autant qu’aucun bénéfice de visibilité n’est démontré.
Pour une entreprise, les priorités restent beaucoup plus fondamentales :
- disposer d’informations fiables ;
- produire des contenus réellement utiles ;
- conserver une architecture claire ;
- utiliser correctement le HTML sémantique ;
- exploiter les données structurées lorsqu’elles sont pertinentes ;
- maintenir la cohérence des informations sur l’ensemble du site ;
- vérifier leur accessibilité technique.
Les Markdown Feeds méritent en revanche d’être surveillés et expérimentés.
Non pas parce qu’ils constitueraient une nouvelle recette GEO.
Mais parce qu’ils montrent dans quelle direction une partie de l’infrastructure du Web commence à évoluer.
Que retenir ?
WordPress AI 1.4.0 introduit expérimentalement une nouvelle façon d’exposer le contenu d’un site : une représentation Markdown disponible en parallèle du HTML traditionnel.
La fonctionnalité est proposée par le plugin canonique AI et non par le cœur de WordPress.
Elle permet notamment de disposer d’un feed /feed/markdown/ et de demander la représentation Markdown d’un article ou d’une page avec ?output_format=markdown. Les principales structures éditoriales — titres, liens, images, listes, citations ou code — sont conservées.
L’intérêt est simple : fournir aux agents IA, modèles de langage et outils automatisés une représentation du contenu moins dépendante de toute la complexité nécessaire à son affichage dans un navigateur.
Cela ne signifie absolument pas qu’un site proposant du Markdown sera mieux classé ou davantage cité par ChatGPT, Google AI Overviews ou un autre moteur génératif.
Aucune preuve ne permet aujourd’hui de l’affirmer.
Mais la nouveauté mérite malgré tout l’attention des directions marketing et digitales.
Car elle pose une question qui dépasse largement WordPress :
Sommes-nous en train de passer d’un Web dans lequel les machines interprètent les pages destinées aux humains à un Web dans lequel les éditeurs proposent également des représentations explicitement pensées pour les machines ?
HTML, données structurées, API, Markdown, embeddings : ces technologies ne s’opposent pas. Elles peuvent devenir différentes interfaces autour d’une même information.
Et c’est peut-être là que se situe l’un des véritables enjeux du GEO.
Non pas écrire pour les robots à la place des humains.
Mais produire une information suffisamment fiable, structurée et accessible pour être correctement comprise par les deux.
Sources
- WordPress AI — “What’s new in AI 1.4.0 (5 OCTOBER 2026)?” : annonce officielle de la version 1.4.0, Markdown Feeds et infrastructure d’embeddings. (Make WordPress)
- WordPress.org Plugin Directory — AI : version 1.4.0 et changelog officiel du plugin canonique. (WordPress.org)
- Make WordPress.org — “Markdown now available on WordPress.org” : déploiement du Markdown sur WordPress.org et motivations liées aux agents IA et LLM. (Make WordPress)
- Google Search Central — Introduction aux données structurées : rôle des données structurées dans la compréhension explicite du contenu. (Google for Developers)
- Schema.org : rôle du vocabulaire partagé pour décrire les entités, leurs propriétés et leurs relations. (Schema.org)

0 commentaires